BrowserAct : le guide ultime pour transformer n'importe quel site web en source de données en 2026
Dans cet article, vous trouverez tout ce qu'il faut savoir sur BrowserAct : comment cet agent de navigation IA construit un scraper à partir d'une simple consigne, ce que valent réellement ses plans et son système de crédits, les cas d'usage concrets pour les freelances, les TPE et les PME, ses intégrations avec Make, n8n et Zapier, et les limites à connaître avant de vous abonner.
Ce qu'est BrowserAct et à qui ce guide s'adresse 🧭
Bénéficiez de notre deal gratuit sur BrowserAct.
-50% sur l'abo. mensuel pendant 1 mois
Retrouvez +300 deals gratuits ainsi que +850 deals Premium dès maintenant avec BrowserAct et faites des économies sur l'abonnement à vos logiciels. Que vous soyez un entrepreneur, une startup ou un indépendant solo, économisez des centaines d'euros grâce à nos réductions et codes promo.
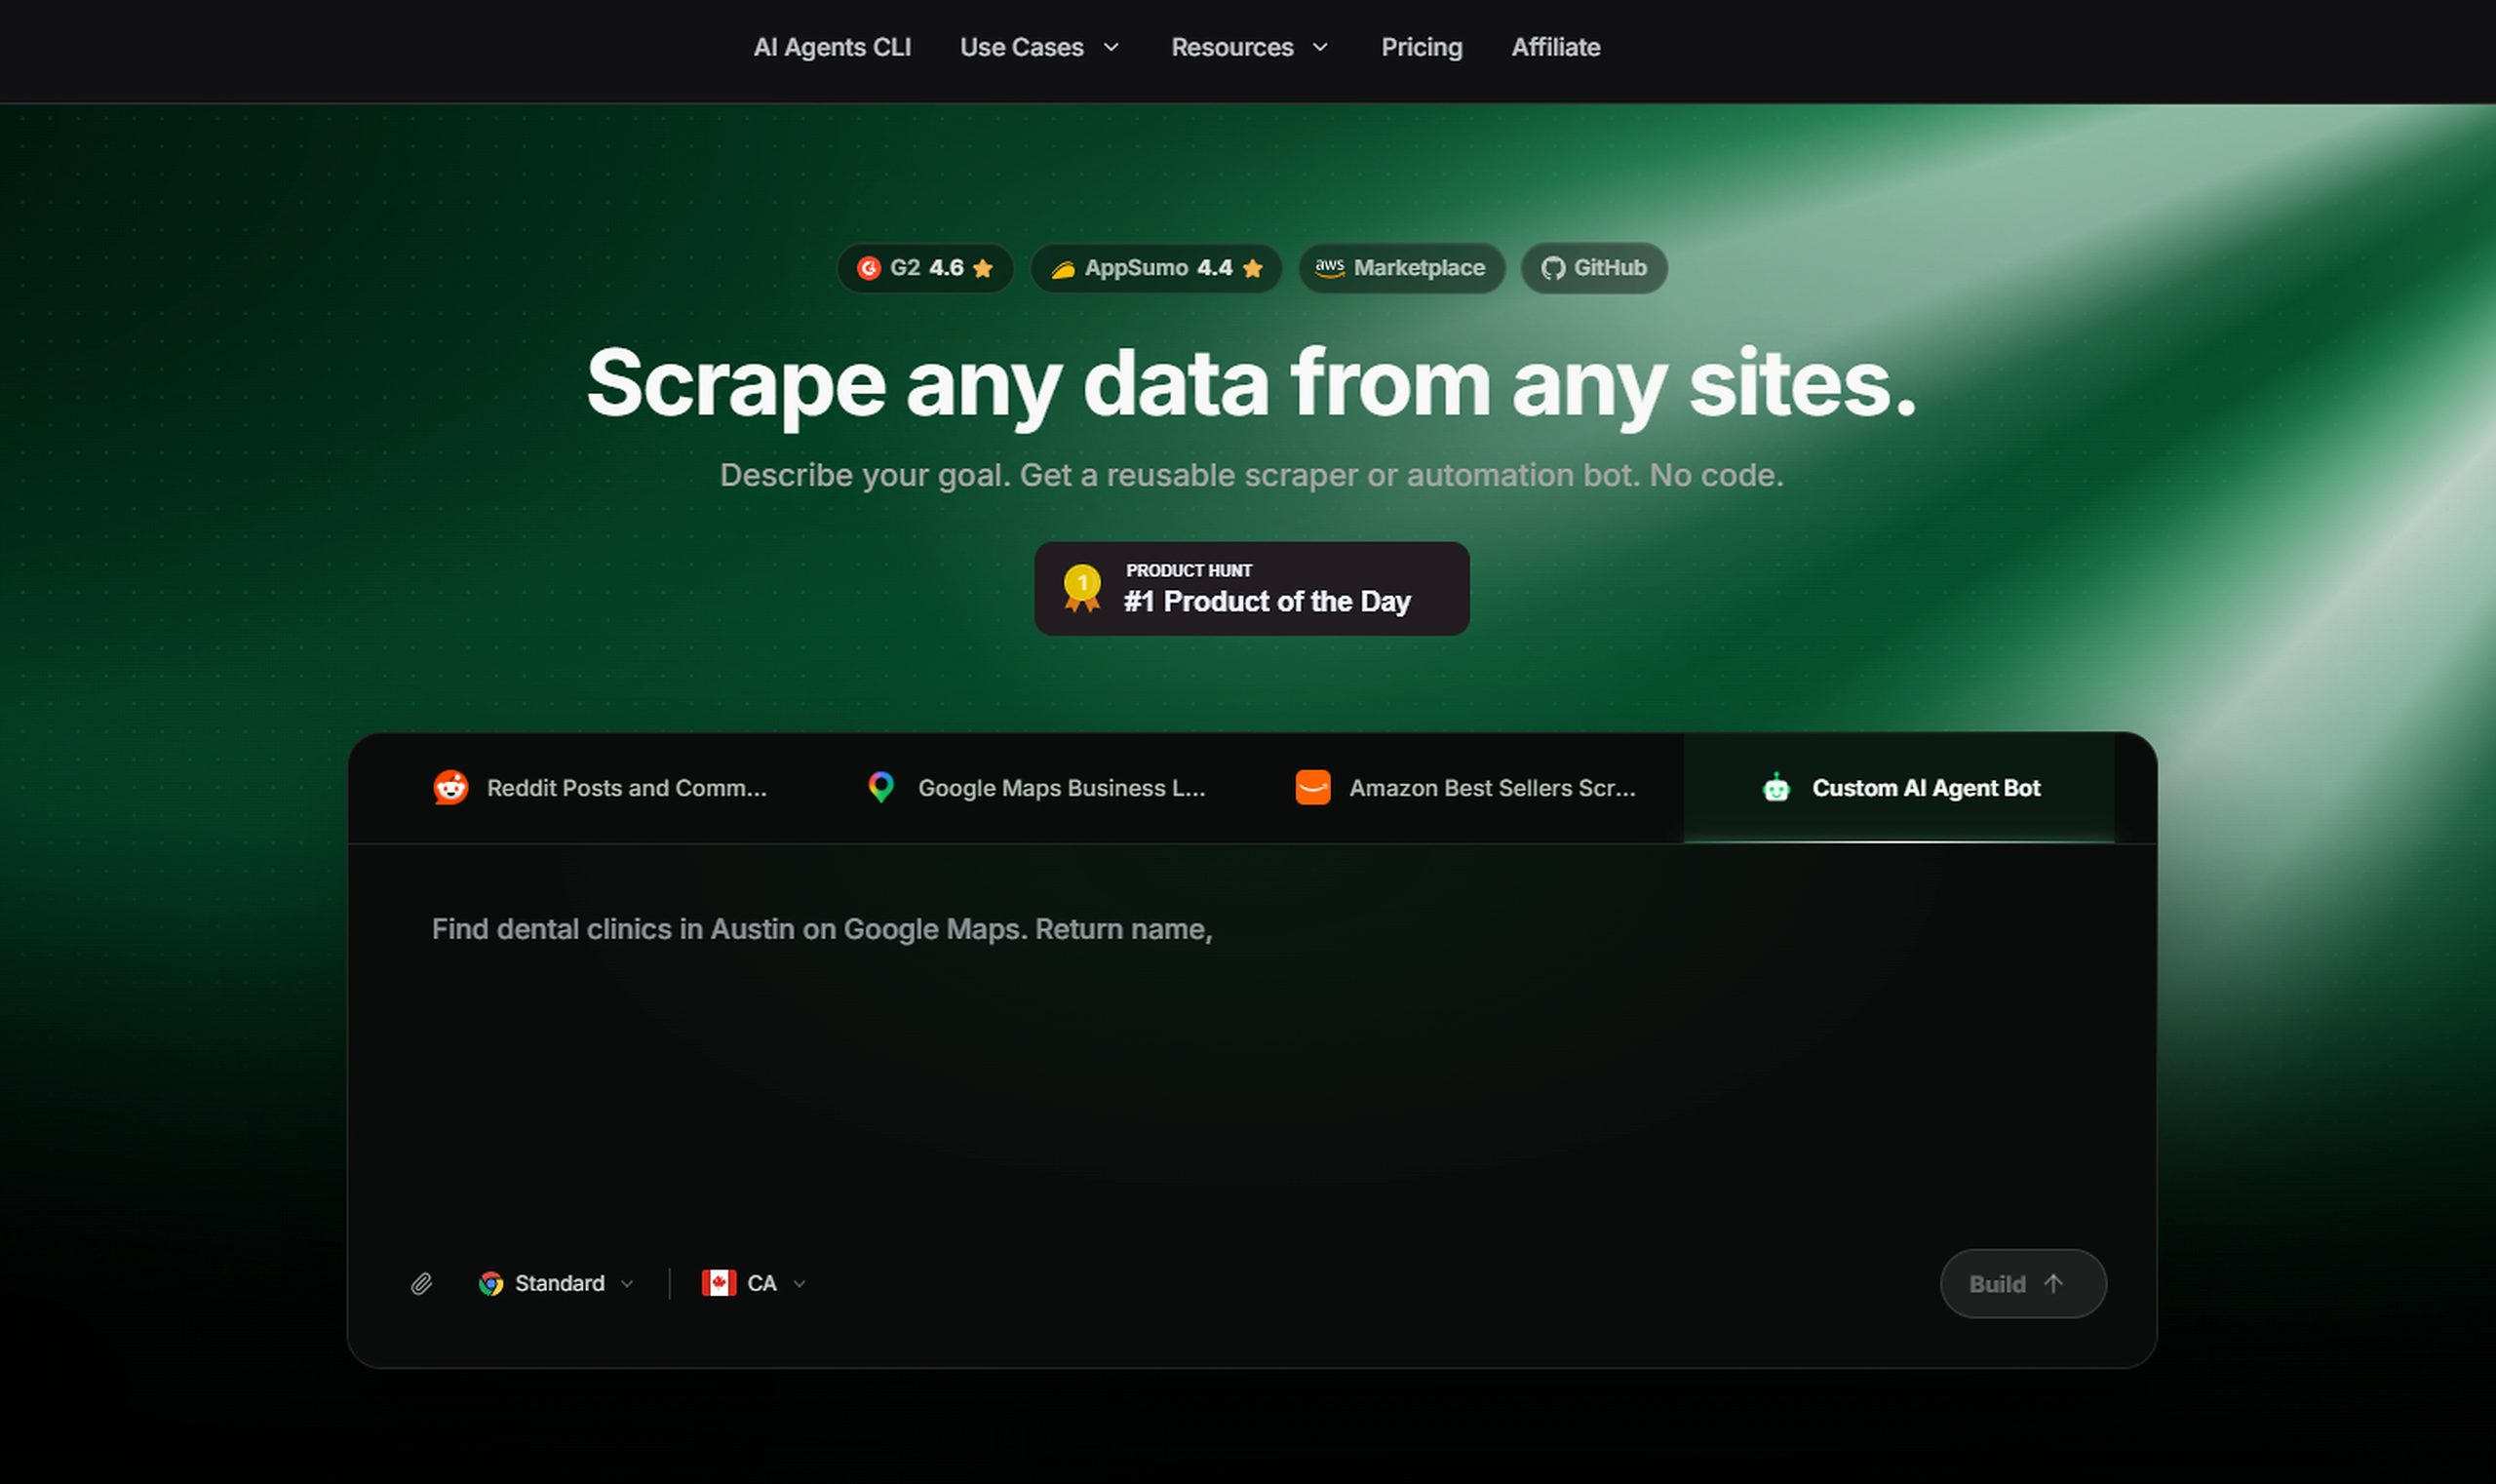
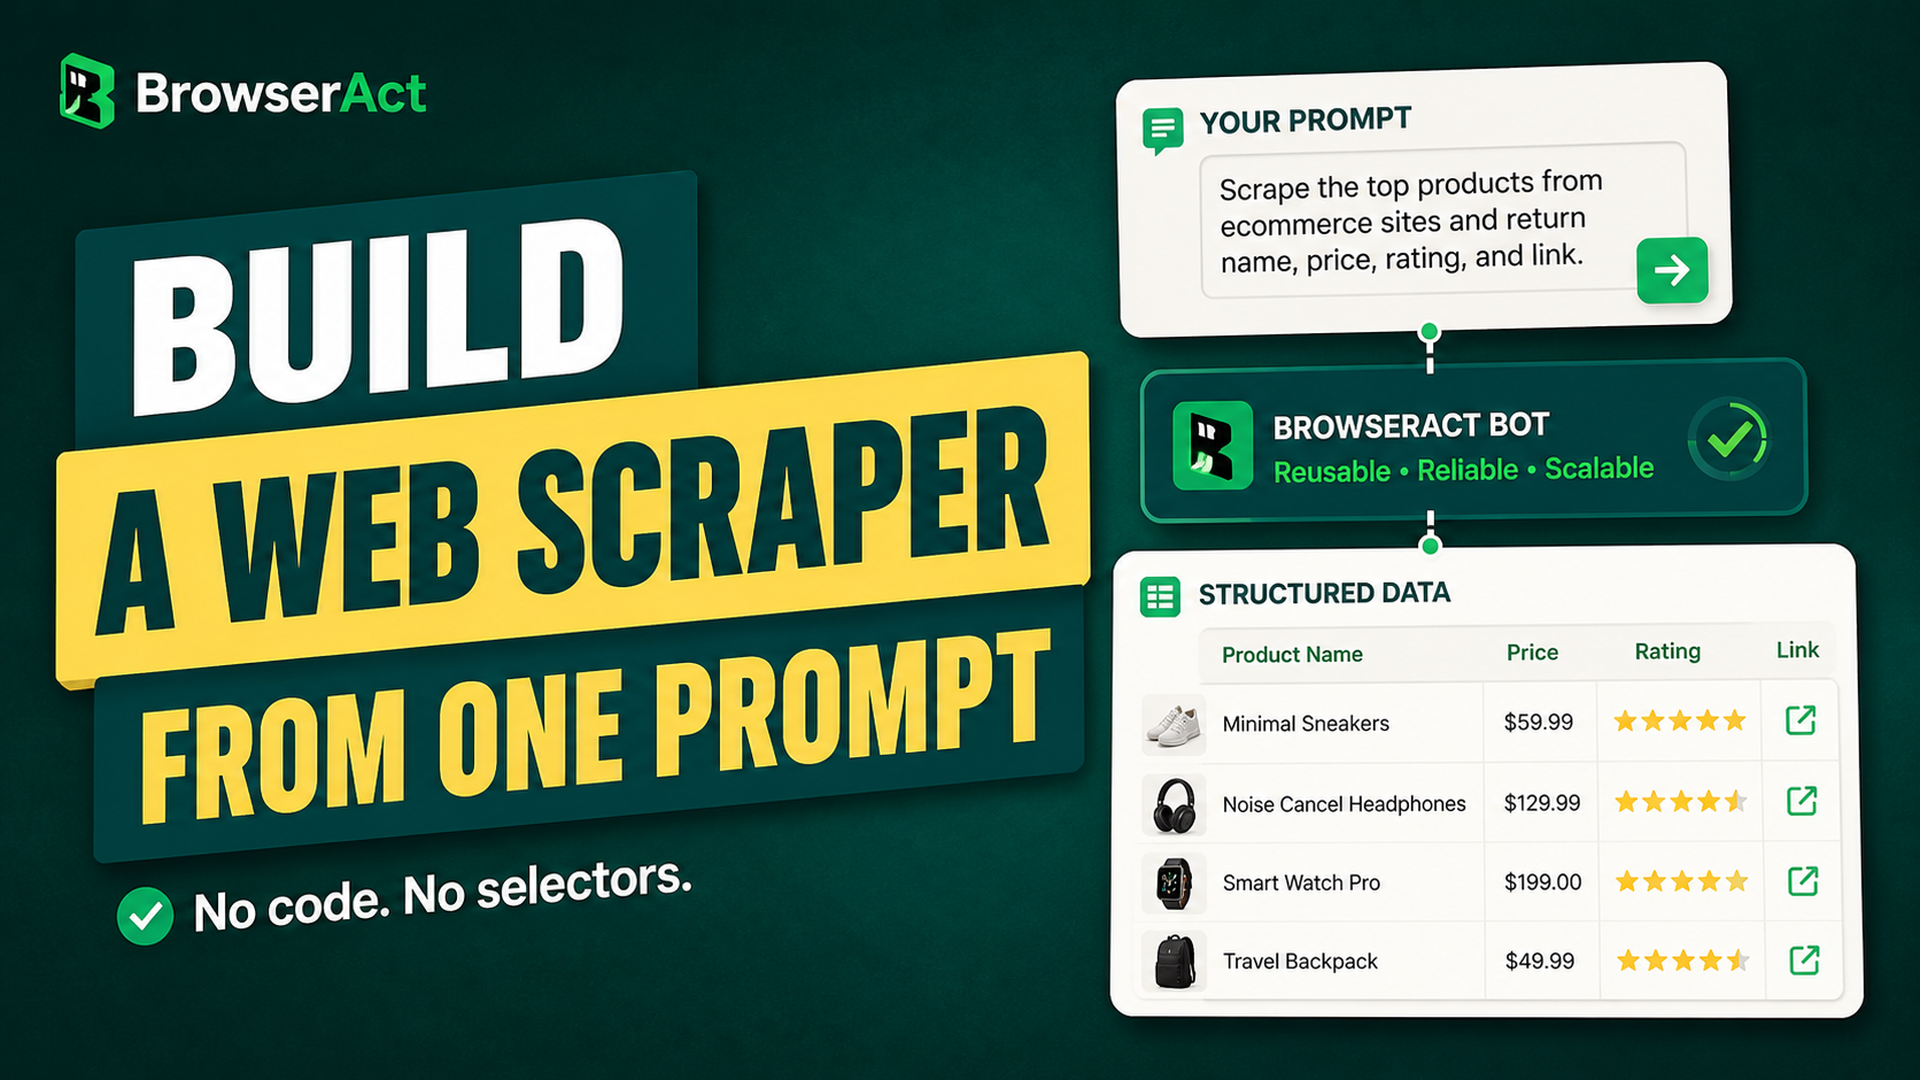
BrowserAct est une plateforme d'automatisation de navigateur qui construit un scraper réutilisable à partir d'une consigne écrite en langage courant, sans code et sans sélecteur CSS à maintenir.
Derrière cette promesse se cache un problème familier aux indépendants et aux petites structures. La donnée web utile existe, elle est visible à l'œil nu, mais elle reste enfermée dans des pages qu'il faut ouvrir une par une. Un consultant qui surveille les tarifs de vingt concurrents, une agence qui reconstitue une liste de prospects depuis un annuaire local, un e-commerçant qui vérifie ses positions produit sur une marketplace : tous répètent le même geste, et tous finissent par y renoncer faute de temps.
Ce guide s'adresse aux freelances, consultants, fondateurs de startup et TPE/PME de moins de cent salariés qui n'ont pas d'ingénieur data sous la main. Vous y trouverez le fonctionnement réel de l'outil, sa grille tarifaire décodée crédit par crédit, cinq scénarios transposables tels quels, les intégrations qui comptent et, surtout, ses limites. Un scraper qui casse au bout de trois semaines coûte plus cher qu'un tableur rempli à la main.
Quelques repères pour situer le produit : BrowserAct a décroché la première place du Product of the Day sur Product Hunt le 25 juin 2026, et affiche 4,6 sur G2 comme 4,4 sur AppSumo. Des signaux plutôt bons, insuffisants pour décider à votre place. Entrons dans le détail.
La plupart des outils d'extraction reposent sur le même principe. Vous désignez un élément sur la page, l'outil mémorise son emplacement dans le code source, puis revient le chercher à chaque exécution. Le jour où le site refond son template, le sélecteur pointe dans le vide et votre automatisation renvoie des colonnes vides.
BrowserAct inverse la logique. Vous décrivez le résultat attendu, l'agent explore le site en direct, teste plusieurs chemins de navigation, valide les champs qu'il rapporte, puis publie un bot réutilisable. L'intelligence est mobilisée pendant la construction ; les exécutions suivantes s'appuient sur l'automatisation publiée, ce qui évite de repayer du raisonnement à chaque lancement. C'est un choix d'architecture assumé par l'éditeur, et il explique pourquoi le coût d'un bot chute nettement après sa mise au point.
➡️Les problèmes que l'outil règle vraiment :
Le blocage anti-bot arrive en tête des obstacles. Cloudflare, DataDome et leurs équivalents repèrent en quelques millisecondes qu'un navigateur automatisé n'a ni historique, ni rendu graphique cohérent, ni empreinte crédible. BrowserAct fait tourner des sessions Chromium avec plus de trente attributs d'empreinte et une infrastructure d'adresses IP résidentielles, ce qui suffit à franchir une bonne partie des contrôles avant même qu'un CAPTCHA n'apparaisse.
Viennent ensuite les pages qui exigent une connexion. Extraire un tableau de bord interne, un espace client ou une plateforme d'annonces réservée aux membres suppose de gérer des cookies, du SSO, parfois un code reçu par SMS. La plateforme propose une session persistante et un mécanisme de reprise par un humain quand la machine bute sur une vérification.
La maintenance constitue le troisième frein, et souvent le plus coûteux. Quand une page évolue, le bot détecte l'échec du chemin habituel, en cherche un nouveau, le vérifie, puis reprend la tâche. Cette auto-réparation n'est pas infaillible, elle absorbe néanmoins les petites refontes qui cassaient systématiquement les scrapers à sélecteurs.
Le dernier obstacle est plus discret : la collision entre sessions. Si vous pilotez trois comptes clients sur une même plateforme, un navigateur unique mélange les cookies et vous fait repérer. Chaque profil BrowserAct dispose de sa propre identité et de son espace de travail isolé.
➡️Face à Browse AI, Apify et Firecrawl :
Trois alternatives reviennent systématiquement dans les comparaisons, et chacune répond en réalité à une question différente.
Outil
Approche
Point fort
Tarif d'entrée observé
BrowserAct
Un agent explore le site et construit un bot réutilisable
Sites protégés, pages avec login, interaction complexe
0 $ avec 200 crédits offerts, puis 20 $/mois au tarif public
Alimentation de bases de connaissances et de projets RAG
500 crédits gratuits, puis environ 16 $/mois
La différence utile n'est pas tarifaire, elle est fonctionnelle. Firecrawl excelle pour avaler un site public et le rendre lisible par un modèle de langage : c'est un convertisseur, pas un opérateur. Browse AI reste très accessible aux profils non techniques pour surveiller une page précise dans la durée. Apify propose une bibliothèque d'acteurs déjà écrits pour les sites populaires, ce qui demeure imbattable lorsque votre cible figure au catalogue.
BrowserAct occupe un autre terrain : la donnée située derrière un formulaire, un filtre, une pagination capricieuse ou un mur de vérification, quand vous n'avez pas envie d'y consacrer vos soirées.
La plateforme fonctionne sur un abonnement qui alimente une réserve de crédits mensuels. Ces crédits sont ensuite consommés par l'ensemble des services : construction et exécution des bots, étapes de workflow, proxies, navigateurs à empreinte locale.
Plan
Mensuel affiché
Annuel (équivalent mensuel)
Crédits mensuels
Tâches simultanées
Proxies statiques
Free Trial
0 $
0 $
200 crédits à l'inscription
2
non inclus
Basic
16 $ au lieu de 20 $
13 $, soit 156 $ par an
10 000
10
jusqu'à 5
Essential
70 $ au lieu de 100 $
56 $, soit 672 $ par an
50 000
20
jusqu'à 25
Advanced
120 $ au lieu de 200 $
96 $, soit 1 152 $ par an
100 000
40
jusqu'à 50
Les trois offres payantes incluent un essai gratuit de sept jours et une dotation de crédits à la première souscription : 1 000 sur Basic, 1 500 sur Essential, 2 000 sur Advanced. Les serveurs MCP sont illimités sur toutes les formules payantes. Le plan gratuit donne droit à deux constructions d'agent et cinq navigateurs locaux, de quoi tester sérieusement avant de sortir la carte bleue.
Le règlement passe par PayPal ou par carte via Stripe. La facture, elle, se demande au support. Un détail qui a son importance pour une comptabilité française habituée à récupérer ses justificatifs automatiquement.
✅Comprendre le système de crédits :
C'est ici que se joue le coût réel, et la documentation a le mérite d'être explicite.
Pour un bot monté dans le Workflow Builder visuel, la règle tient en une ligne : une étape exécutée vaut cinq crédits. Naviguer, cliquer, saisir du texte, extraire, attendre, revenir en arrière, faire défiler, chaque action compte pour cinq. Les boucles se multiplient logiquement : une boucle sur trente éléments d'une liste consomme trente fois cinq crédits, soit cent cinquante.
Pour un bot construit par l'agent, la consommation dépend de la tâche et se lit dans l'historique d'exécution. La phase d'exploration initiale coûte sensiblement plus cher que les exécutions suivantes, puisque l'agent teste plusieurs chemins avant de figer l'automatisation.
Trois lignes d'infrastructure viennent s'ajouter. Un proxy dynamique est facturé 5 000 crédits par gigaoctet, soit environ 3,20 $. La création d'un navigateur à empreinte locale coûte 100 crédits, prélevés à chaque création et non remboursés si vous supprimez le profil. Les proxies statiques se paient au mois, selon la localisation et le niveau retenu. Le navigateur cloud est gratuit pour une durée limitée, ce qui ne durera sans doute pas.
Un point de vigilance mérite d'être souligné : les crédits mensuels sont consommés en priorité, et les Credit Packs achetés en cours de cycle ne sont pas permanents. Ils expirent à la réinitialisation mensuelle. Mieux vaut estimer correctement son volume que racheter dans l'urgence.
✅Combien coûte un bot, en pratique :
Prenons un cas chiffrable. Vous surveillez chaque matin les vingt premiers résultats d'une catégorie produit sur une marketplace, avec le prix, la note et la disponibilité.
En Workflow Built, comptez une étape de navigation, une recherche, une saisie, puis une boucle sur vingt éléments avec extraction. Le total tourne autour de 120 à 150 crédits par exécution, hors bande passante proxy. Sur trente jours, vous consommez entre 3 600 et 4 500 crédits : le plan Basic et ses 10 000 crédits absorbent ce scénario avec de la marge pour deux ou trois bots légers en parallèle.
Les templates officiels affichent d'ailleurs leur coût estimé avant lancement. Un scraper de fiches Google Maps est annoncé autour de 18 à 25 crédits par exécution, un extracteur de posts et commentaires Reddit entre 17 et 45 selon le volume. Ces ordres de grandeur permettent de bâtir un budget mensuel réaliste plutôt que de découvrir la facture après coup.
Le vrai poste de dépense imprévu reste le proxy dynamique. Une collecte lourde en images ou en pages volumineuses consomme de la bande passante, et 5 000 crédits par gigaoctet grimpent vite. Désactiver le chargement des images quand vous n'en avez pas l'usage fait une différence mesurable sur la facture.
Prise en main : votre premier bot en dix minutes ⚡
🔵Création du compte et premiers repères :
L'inscription se fait par e-mail, ou via Google et GitHub. Quelques questions d'onboarding plus tard, vous arrivez dans le tableau de bord cloud avec vos 200 crédits offerts.
L'interface s'organise autour de quatre zones. La Home accueille la barre de prompt et des suggestions de consignes prêtes à l'emploi. Bots regroupe vos automatisations publiées, avec pour chacune son identifiant, son historique et ses réglages de navigateur. Tasks liste toutes les exécutions, réussies ou non, avec les crédits consommés. Le Workflow Builder enfin, accessible depuis Create, propose la construction visuelle nœud par nœud pour ceux qui veulent garder la main.
🔵Rédiger une consigne qui produit un bon bot :
C'est l'étape qui détermine la qualité du résultat, et celle que l'on bâcle le plus souvent. Une consigne efficace précise six éléments : le site de départ, les enregistrements à collecter, les conditions de filtrage, les champs exacts attendus en sortie, la limite de résultats et les variables que vous voudrez modifier lors des exécutions suivantes.
Une consigne vague du type « récupère les prix des concurrents » produira un bot approximatif. Une consigne du type « ouvre la page des meilleures ventes de la catégorie Chaussures, collecte les vingt premiers produits, renvoie le rang, le nom, le prix, la note, le nombre d'avis et l'URL du produit » produit un bot exploitable dès le premier essai.
Le paramètre le plus rentable reste la variable d'entrée. En indiquant que le mot-clé de recherche doit rester modifiable, vous obtenez un bot unique réutilisable sur cent requêtes différentes, au lieu de cent bots à maintenir.
🔵Lancer, lire, corriger :
Une fois la consigne soumise, l'agent explore le site sous vos yeux. Il navigue, applique des filtres, fait défiler, suit la pagination, ouvre des pages de détail, vérifie les champs de sortie. S'il manque une information, il vous la demande dans la même conversation de construction : ajoutez l'URL, la condition ou l'exemple attendu, et il reprend son exploration.
La construction terminée, le bouton Run lance la première exécution réelle. Vous obtenez un jeu de données structuré, exportable en CSV ou en JSON.
Si le résultat ne correspond pas tout à fait, n'effacez pas le bot pour en créer un autre. La fonction Improve Bot permet de décrire la modification souhaitée, de tester le brouillon, puis de publier une nouvelle version que les exécutions suivantes utiliseront automatiquement. Reconstruire depuis zéro consomme des crédits pour rien.
Les fonctionnalités clés de BrowserAct 🔧
🟢Agent Built ou Workflow Built : deux façons de construire :
La plateforme propose deux méthodes, et le choix a des conséquences concrètes sur votre organisation.
L'Agent Built part d'une description en langage naturel :
C'est rapide, adapté aux sites que vous découvrez et aux besoins qui bougent. Deux restrictions à connaître : un bot construit par l'agent ne peut être ni copié ni partagé avec un collègue, et l'hébergement des identifiants de connexion n'est pas encore disponible sur ce mode.
Le Workflow Built vous fait assembler des nœuds dans un éditeur visuel :
Visite de page, clic, survol, saisie, défilement, pagination, attente, condition, boucle, boucle de liste, extraction, interaction humaine, sortie de données. C'est plus long à mettre en place, plus prévisible en coût, et surtout partageable. Un clic sur « Save as Template » transforme votre bot en modèle réutilisable par un collaborateur, sans lui donner accès à votre historique ni à vos identifiants.
Beaucoup d'utilisateurs commencent en Agent Built pour valider la faisabilité, puis reconstruisent en Workflow les automatisations critiques qu'il faudra documenter et transmettre.
🟢Navigateur standard, navigateur privé :
Ce réglage explique la majorité des erreurs rencontrées par les nouveaux utilisateurs. Un bot en navigateur standard réutilise le même environnement persistant : idéal pour rester connecté à un site, mais limité à une seule tâche active à la fois. Lancer deux exécutions simultanées sur ce bot génère une erreur.
Le navigateur privé ouvre au contraire une session neuve à chaque lancement, ce qui autorise les exécutions parallèles dans la limite prévue par votre plan. Retenez la règle : session connectée, navigateur standard ; volume et parallélisme, navigateur privé.
🟢Proxies et ciblage géographique :
Trois options coexistent. Le proxy dynamique fait tourner des IP résidentielles avec couverture mondiale et ciblage par pays, facturé à la bande passante. Le proxy statique fournit une adresse dédiée dans la durée, pertinent pour gérer un compte sans déclencher d'alerte de connexion. Vous pouvez également brancher votre propre fournisseur, ce qui évite de consommer des crédits si vous avez déjà un contrat ailleurs, chez Bright Data par exemple.
Le ciblage par pays a une utilité directe pour les e-commerçants : prix, stocks et résultats de recherche varient selon la localisation de l'adresse IP. Surveiller un concurrent depuis une adresse française et depuis une adresse allemande ne renvoie pas les mêmes données.
🟢CAPTCHA et vérification humaine :
BrowserAct prend en charge les CAPTCHA courants et les processus de vérification, avec une intervention humaine lorsque cela s'avère nécessaire.
Quand le défi dépasse ses capacités, notamment pour un code reçu par e-mail ou SMS ou une confirmation sur appareil, le human-in-the-loop prend le relais. Le bot met la tâche en pause, vous reprenez la main dans le navigateur, vous validez, l'automatisation repart. Ce mécanisme mérite d'être anticipé avant de planifier des exécutions nocturnes, sans quoi vos tâches attendront votre réveil.
🟢Sites protégés par un login :
Pour un bot Workflow, la marche à suivre est balisée : enregistrez le compte dans le Credential Center, autorisez le bot à l'utiliser, activez les identifiants stockés dans le nœud de départ. Vous pouvez aussi opter pour une saisie à chaque exécution si vous préférez ne rien conserver sur la plateforme.
Pour un bot Agent, la connexion se fait manuellement au premier passage via l'assistance humaine, avec le navigateur standard pour conserver la session. L'hébergement d'identifiants sur ce mode est annoncé comme à venir.
Un rappel de bon sens avant d'automatiser un espace connecté : vérifiez ce que disent les conditions d'utilisation du site concerné. Accéder à votre propre compte n'a rien à voir avec l'aspiration d'une plateforme tierce.
🟢Auto-réparation et robustesse :
Quand la structure d'une page change, le système détecte l'échec, cherche une alternative, la vérifie, puis reprend la tâche. Les retours publiés sur AppSumo mentionnent régulièrement ce point comme le gain le plus tangible, la maintenance des sélecteurs étant historiquement la corvée numéro un du scraping.
Ne comptez pas sur une fiabilité absolue pour autant. Une refonte complète de site oblige à repasser par Improve Bot. Activez l'alerte d'échec de tâche : elle vous prévient avant que trois semaines de données manquantes ne soient constatées dans votre reporting.
🟢Formats de sortie, planification et API :
Les résultats s'exportent en CSV, JSON, XML ou Markdown. Ils peuvent aussi partir directement vers vos outils via Make, n8n, Zapier, l'API REST ou des webhooks.
L'API expose l'essentiel : lancer un bot, lancer un template officiel, récupérer le statut d'une tâche, lister les exécutions, annuler, reprendre une tâche en pause, lister les régions de proxy disponibles. De quoi intégrer proprement la collecte dans un produit existant sans dépendre de l'interface.
Cinq cas d'usage concrets pour freelances, TPE et PME 🧩
✅Veille tarifaire pour un e-commerçant :
Vous vendez une quarantaine de références et trois concurrents jouent sur les mêmes mots-clés. Construisez un bot qui ouvre chaque page produit concurrente, relève le prix affiché, la mention de promotion, le délai de livraison et la disponibilité, puis renvoie un CSV daté.
Une exécution quotidienne à sept heures, un envoi vers Airtable ou une feuille de calcul Google Workspace via Make, et vous disposez d'un historique de prix exploitable au bout d'un mois. C'est cet historique, et non la photographie du jour, qui révèle les cycles promotionnels de vos concurrents.
✅Constitution d'une liste de prospects locaux :
Un bot qui parcourt les résultats d'un annuaire ou d'une carte, collecte le nom de l'établissement, la catégorie, l'adresse, la note, le site web et les coordonnées publiques vous évite trois heures de copier-coller par secteur géographique.
La suite du traitement compte autant que la collecte. Passez la liste dans Dropcontact ou Hunter pour la fiabiliser, poussez-la dans votre CRM, puis appliquez une séquence raisonnée avec Lemlist. Point juridique développé plus bas : la constitution d'un fichier de prospection à partir de données personnelles glanées en ligne obéit à des règles précises, et les ignorer expose à bien plus qu'un mauvais taux de réponse.
✅Veille sur les pages de tarification concurrentes :
Pour un éditeur de SaaS, les pages de prix des concurrents sont une mine. Un bot hebdomadaire qui relève chaque plan, son montant, ses quotas et les mentions de nouveautés vous alerte dès qu'un acteur bouge sa grille.
L'astuce consiste à comparer la sortie de la semaine avec celle de la précédente et à ne déclencher une notification Slack que lorsqu'un écart apparaît. Vous transformez une veille passive en signal actionnable, sans lire quinze pages tous les lundis.
✅Agrégation d'offres de mission pour un indépendant :
Les plateformes de missions ne proposent pas toutes des alertes fines, et leurs filtres restent grossiers. Un bot qui interroge plusieurs sources avec vos critères, dédoublonne et renvoie une liste unique chaque matin vous fait gagner la demi-heure de balayage quotidien.
Le montage se marie bien avec n8n : collecte par BrowserAct, filtrage sur votre TJM cible et vos technologies, envoi dans un canal Slack ou une base Notion dédiée. Certains ajoutent une étape de scoring par un modèle de langage pour trier les annonces par pertinence avant lecture.
✅Collecte d'avis clients pour une étude de marché :
Avant de lancer une fonctionnalité, rien ne vaut la lecture de ce que les utilisateurs reprochent aux produits existants. Un bot qui rassemble plusieurs centaines d'avis publics, avec la note, la date et le texte, fournit un corpus exploitable en une soirée.
Le traitement se fait ensuite par analyse sémantique : regroupement des irritants récurrents, comptage des occurrences, extraction des verbatims les plus parlants. Un agent monté sur Relevance AI suffit à transformer un fichier brut en note de synthèse présentable à un comité.
Astuces avancées et réglages que peu d'utilisateurs connaissent 🧠
Partez d'un template plutôt que d'une page blanche :
Le catalogue officiel couvre les cibles les plus courantes et affiche son coût estimé avant exécution. Vous pouvez créer un duplicata modifiable pour l'adapter à votre besoin, ce qui économise toute la phase d'exploration facturée.
Récupérez les crédits bonus :
L'éditeur accorde 2 000 crédits pour un avis approuvé sur G2, capture de validation à l'appui, et 500 crédits pour une étoile sur le dépôt GitHub officiel. Sur un plan Basic, cela représente un quart d'un mois d'usage.
Coupez le chargement des images sur les collectes qui n'en ont pas besoin :
Le proxy dynamique étant facturé au gigaoctet, la bande passante inutile est le poste de dépense le plus facile à réduire.
Vérifiez le mode de navigateur avant de planifier :
Une tâche nocturne en navigateur standard qui se chevauche avec une autre échouera, et vous perdrez la fenêtre d'exécution.
Testez d'abord la lecture simple :
Si votre besoin se limite à récupérer le contenu d'une page rendue en JavaScript, la commande "stealth-extract" de l'Agent CLI ouvre un navigateur furtif, renvoie la page en Markdown et se referme. Bien plus économique qu'une session complète.
Transformez vos bots Workflow en modèles internes :
Une agence qui gère vingt clients sur le même type de collecte n'a aucune raison de reconstruire vingt fois : un modèle, vingt instanciations, une seule logique à corriger le jour où le site évolue.
Activez l'alerte d'échec de tâche :
Dès votre premier bot en production. Découvrir un mois plus tard que la collecte s'est arrêtée le 4 du mois est une expérience désagréable et parfaitement évitable.
Intégrations et écosystème 🔌
➡️Make, n8n et Zapier :
Les trois connecteurs officiels permettent de lancer un bot depuis un scénario existant et d'en récupérer les résultats structurés. La documentation détaille notamment l'envoi automatique vers une feuille Google Sheets et la planification d'exécutions récurrentes via Make, l'ordonnancement natif restant limité.
Le choix dépend de votre stack. Make offre le meilleur rapport visuel/puissance pour un profil non technique. n8n séduit ceux qui veulent héberger eux-mêmes et manipuler du code quand nécessaire. Zapier conserve l'avantage du nombre d'applications connectables.
Les scénarios Make et les workflows n8n s'exportent en JSON, ce qui facilite le partage entre membres d'une équipe ou la duplication d'un montage d'un client à l'autre.
➡️MCP et agents IA :
Les bots publiés peuvent être exposés comme outils MCP, donc appelés directement par un assistant compatible. Votre agent conversationnel devient capable de déclencher une collecte et d'en exploiter le résultat dans la foulée, sans que vous ouvriez la plateforme.
C'est là que le positionnement de l'éditeur prend tout son sens : il ne vend pas seulement un scraper, il vend une couche d'exécution pour agents. Un montage avec Lindy AI ou Relevance AI permet de déléguer la partie raisonnement à l'agent et la partie navigation à BrowserAct, chacun dans son rôle.
➡️Agent CLI pour les profils techniques :
Les développeurs disposent d'une ligne de commande qui pilote un navigateur local, y compris votre Chrome réel avec ses cookies, ses extensions et ses sessions SSO déjà ouvertes. Le fonctionnement repose sur une boucle simple : ouvrir une page, lire son état sous forme d'éléments indexés, agir sur un index, relire l'état, recommencer, fermer la session.
Cette représentation compacte de la page, pensée pour la lecture par un modèle de langage plutôt que pour un humain, évite d'envoyer un DOM entier dans le contexte. La CLI s'installe comme skill dans Claude Code, Cursor, Codex et la plupart des environnements d'agents actuels, et intègre un garde-fou qui exige une confirmation explicite avant la création d'un navigateur ou une opération sensible.
➡️Combiné au reste de votre stack :
La donnée collectée n'a de valeur qu'une fois rangée quelque part. Les montages les plus courants envoient les résultats vers Airtable pour la manipulation, vers un CRM comme Pipedrive pour le commercial, ou vers Supabase quand la donnée alimente un produit. Pour l'enrichissement avant activation, Clay reste la référence côté équipes growth.
Limites de BrowserAct et alternatives selon votre profil ⚠️
🔵Les inconvénients à connaître avant de s'abonner :
Le modèle de crédits :
Il est transparent, mais il demande un minimum de discipline. Un utilisateur qui multiplie les boucles sur de longues listes, sans surveiller la bande passante proxy, videra sa réserve avant la fin du mois et devra racheter des packs qui, eux, expirent au cycle suivant.
Le partage des bots Agent :
Ni copie, ni transmission à un collègue : pour une agence ou une équipe de trois personnes, cette restriction pousse à construire en Workflow les automatisations destinées à circuler, donc à y passer plus de temps.
La gestion des identifiants côté Agent Built :
Elle est encore absente. la connexion manuelle au premier passage fonctionne, elle suppose néanmoins d'être disponible au bon moment et rend les scénarios entièrement autonomes plus fragiles.
Aucune plateforme ne garantit un taux de succès de cent pour cent face aux protections anti-bot :
Les éditeurs de solutions de détection mettent leurs règles à jour en continu. Un bot qui fonctionne parfaitement en janvier peut demander un ajustement en avril.
La facturation en dollars et la facture sur demande :
Elles ajoutent un peu de friction administrative pour une structure française, comparé à un éditeur européen qui envoie sa facture en euros chaque mois.
🔵Le cadre légal, à ne pas traiter en note de bas de page :
Collecter automatiquement de la donnée ne pose pas de difficulté en soi. La manière dont vous l'utilisez ensuite, si.
La CNIL a publié dès avril 2020, puis complété en juin 2024, une position claire sur la réutilisation des données personnelles publiquement accessibles à des fins de démarchage commercial. Le principe à retenir : le caractère public d'une donnée ne la rend pas librement réutilisable. Les personnes doivent être informées de la collecte et de sa finalité, le RGPD s'applique intégralement, et la prospection issue de données aspirées reste très encadrée.
Trois réflexes valent mieux qu'un contrôle : vérifiez les conditions générales d'utilisation du site visé, respectez le fichier robots.txt et les limites de charge que vous imposez au serveur, et distinguez systématiquement les données d'entreprise des données personnelles. Un prix produit, une fiche technique ou un tarif public ne relèvent pas du même régime qu'un nom, un e-mail nominatif ou un profil individuel.
🔵Quelle alternative pour quel besoin :
Votre situation
Piste à privilégier
Pourquoi
Surveiller une page précise et être alerté d'un changement
1️⃣ BrowserAct est-il vraiment utilisable sans savoir coder ?
Oui pour le mode Agent Built et pour le Workflow Builder visuel, qui couvrent la grande majorité des besoins. L'Agent CLI, en revanche, s'adresse à des profils techniques.
2️⃣ Existe-t-il une version gratuite ?
Un plan Free Trial donne 200 crédits à l'inscription, deux constructions d'agent, deux tâches simultanées et cinq navigateurs locaux. Les plans payants ajoutent un essai de sept jours et une dotation de crédits offerts.
3️⃣ Combien coûte BrowserAct par mois ?
Les tarifs publics s'échelonnent de 20 $ pour Basic à 200 $ pour Advanced, avec des prix affichés inférieurs en promotion et une remise d'environ 20 % en engagement annuel.
4️⃣ La plateforme contourne-t-elle les CAPTCHA ?
Elle traite automatiquement reCAPTCHA v2, v3 et Enterprise, Cloudflare Turnstile et Challenge, DataDome ainsi que HUMAN Security. Les codes envoyés par e-mail ou SMS nécessitent votre intervention via le mode human-in-the-loop.
5️⃣ Peut-on extraire des données d'un site nécessitant une connexion ?
Oui. Les bots Workflow utilisent les identifiants stockés dans le Credential Center, les bots Agent passent par une connexion manuelle au premier lancement avec conservation de la session.
6️⃣ Que se passe-t-il si le site change de design ?
Le bot détecte l'échec, cherche un chemin alternatif, le vérifie et reprend la tâche. Pour une refonte profonde, la fonction Improve Bot permet de corriger sans repartir de zéro.
7️⃣ Peut-on planifier des exécutions automatiques ?
Oui, via les connecteurs Make, n8n et Zapier, ou en appelant l'API depuis votre propre ordonnanceur.
8️⃣ Le scraping est-il légal en France ?
Collecter de la donnée publique n'est pas interdit en soi, mais le RGPD s'applique dès qu'il s'agit de données personnelles, et la CNIL encadre strictement leur réutilisation à des fins de prospection. Vérifiez également les conditions d'utilisation du site visé.
9️⃣ Quelle est la meilleure alternative à BrowserAct ?
Cela dépend du besoin : Browse AI pour la surveillance de pages, Apify pour le volume et le catalogue, Firecrawl pour alimenter un projet IA, ScrapingBee ou ScraperAPI pour une intégration par API.
Trois idées résument ce guide. L'outil se distingue par sa capacité à travailler sur des sites réels et protégés, là où la plupart des scrapers s'arrêtent à la page publique. Son modèle de crédits est lisible, à condition de surveiller la bande passante proxy et les boucles. Ses limites actuelles tiennent au partage des bots Agent et à la gestion des identifiants sur ce mode, deux points annoncés comme en évolution.
Le bon réflexe avant de vous engager reste le même que pour n'importe quel SaaS : testez sur le plan gratuit avec un cas d'usage précis, mesurez les crédits consommés sur une semaine, puis choisissez le plan correspondant à votre volume réel plutôt qu'à votre volume espéré. Et pensez à vérifier si une réduction existe sur l'outil avant de souscrire, ainsi que sur les briques qui l'entourent, qu'il s'agisse de votre plateforme d'automatisation ou de votre base de données.